







总部地址
杭州市滨江区西兴街道中国数谷3号楼16楼
景联文科技亮相数博会,拆解具身智能数据“精加工”之道
8月27日至30日,2026中国国际大数据产业博览会举行。期间,景联文科技围绕具身智能数据产业参与多场交流活动,分享对全球具身智能数据发展趋势的观察与实践。
01 从数据饥渴到数据飞轮:构建具身智能的数据方法论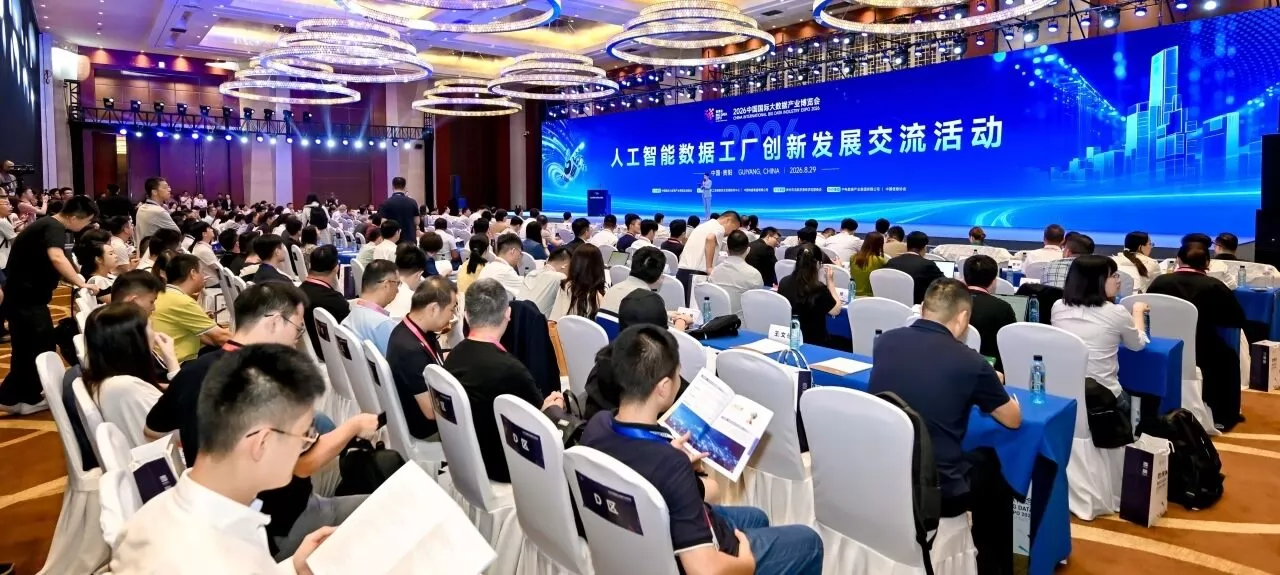
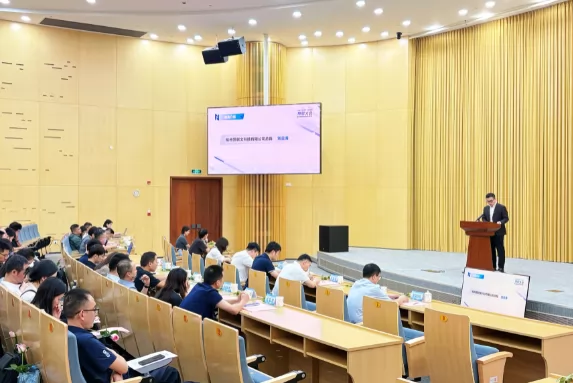
在“人工智能数据工厂创新发展暨全国高质量数据集及数据标注供需对接交流活动”上,景联文科技总裁刘云涛发表主题演讲。
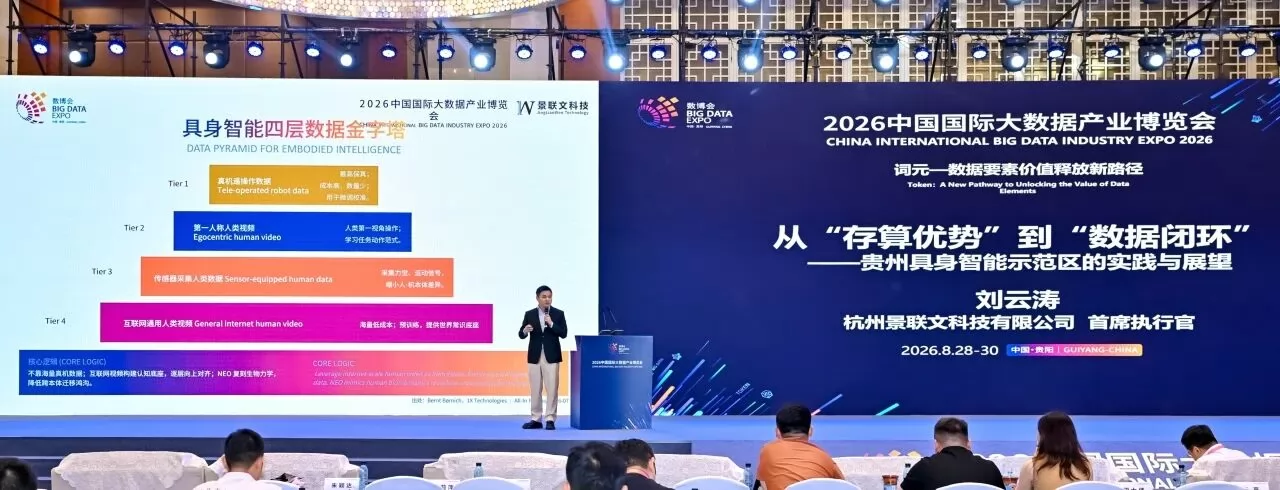
刘云涛表示,具身智能与传统AI最大的不同,在于它需要从真实物理世界中学习。相比互联网时代海量文本、图像数据,机器人所需要的是视觉、语言、动作、触觉、力觉等多模态的真实交互数据。
真正的物理泛化,需要多源异构的具身数据,而不是单纯的机器人遥测数据。 具身智能的数据体系可构建为四层金字塔结构:以互联网规模的人类视频构建世界认知底座,以高质量遥操作数据进行动作对齐,以仿真数据补齐长尾和极端场景,再通过真机在线交互持续获取真实世界反馈。 最终形成: 机器人规模化部署→真实交互数据→模型迭代→泛化能力提升→更大规模部署→产生更多数据。 一个持续自我强化的Data Flywheel(数据飞轮),正在成为具身智能走向规模化的重要基础。 围绕这一产业趋势,景联文正在从“数据生产”进一步走向“数据闭环”。 目前,景联文已成立具身智能研究院,通过对模型能力、本体技术、应用场景和数据需求的前置研究,提前预判下一阶段的数据需求;同时依托SolarSense数据工程平台、QApex数据生态平台,持续提升多模态数据采集、加工、治理与质量控制能力。 02 精加工车间:把物理世界“翻译”成机器能读懂的数据 在具身智能数据要素产业研讨会上,景联文科技副总裁林旭峰围绕数据标注:具身数据的“精加工”车间为主题,分享了具身数据生产实践。 林旭峰指出,具身数据不是简单的“打点画框”,而是对真实物理世界动作的翻译与编码。一个机器人完成抓取动作,背后涉及轨迹、力度、角度、时间等多维信息,数据生产本质上是将真实世界转化为机器可以理解和学习的数据。 当前,景联文已落地智能驾驶、穿戴式智能终端、无本体具身采集等多个方向,共完成37项大型标准化数据采集项目。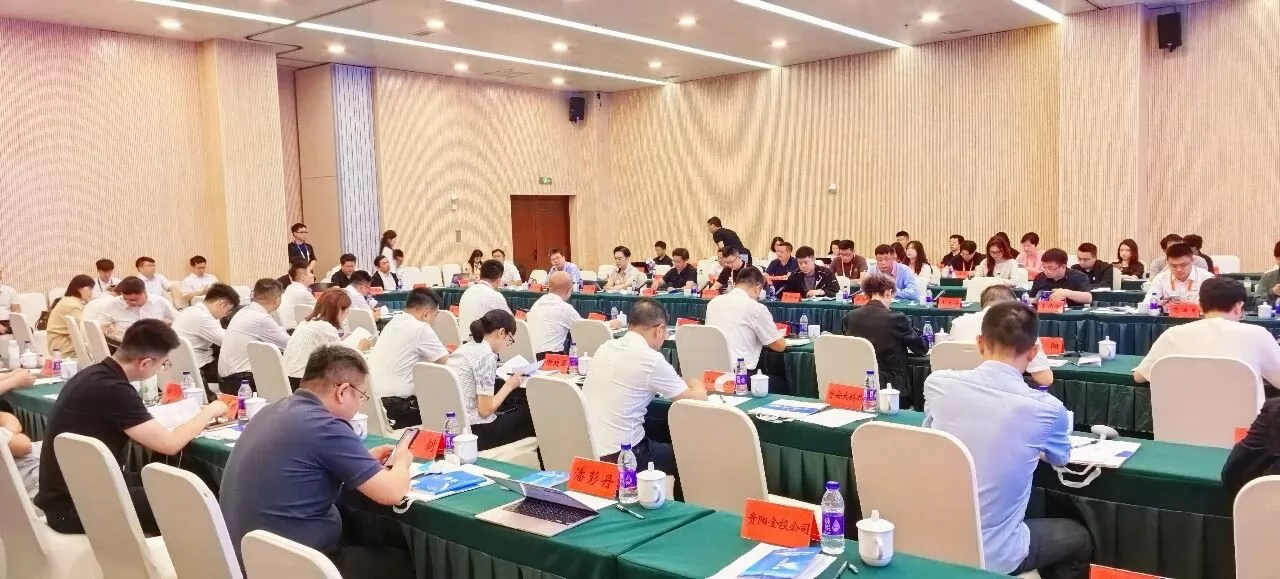
03
共建标准,走向生态:以理性守护产业未来
面对快速增长的“数据饥渴”,刘云涛也提出,行业越是焦虑,越需要保持理性:坚守质量底线、共建行业标准、保持价格理性。
数据产业不能陷入单纯追求数量和低价的竞争,而应真正以数据质量和模型效果衡量数据价值。
他同时倡议,各方应打破物理空间与数据壁垒,共同构建具身智能综合性示范区,让海量真实物理世界的数据源源不断转化为AI演进的核心要素。
这一倡议也与产业界正在推进的标准共建形成呼应。
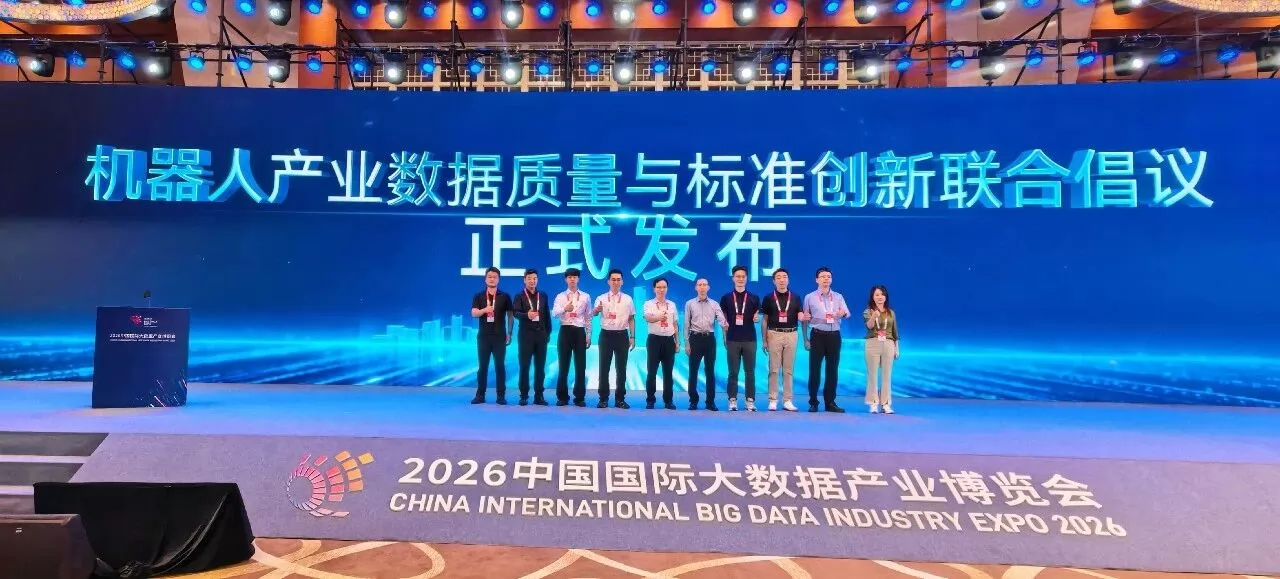
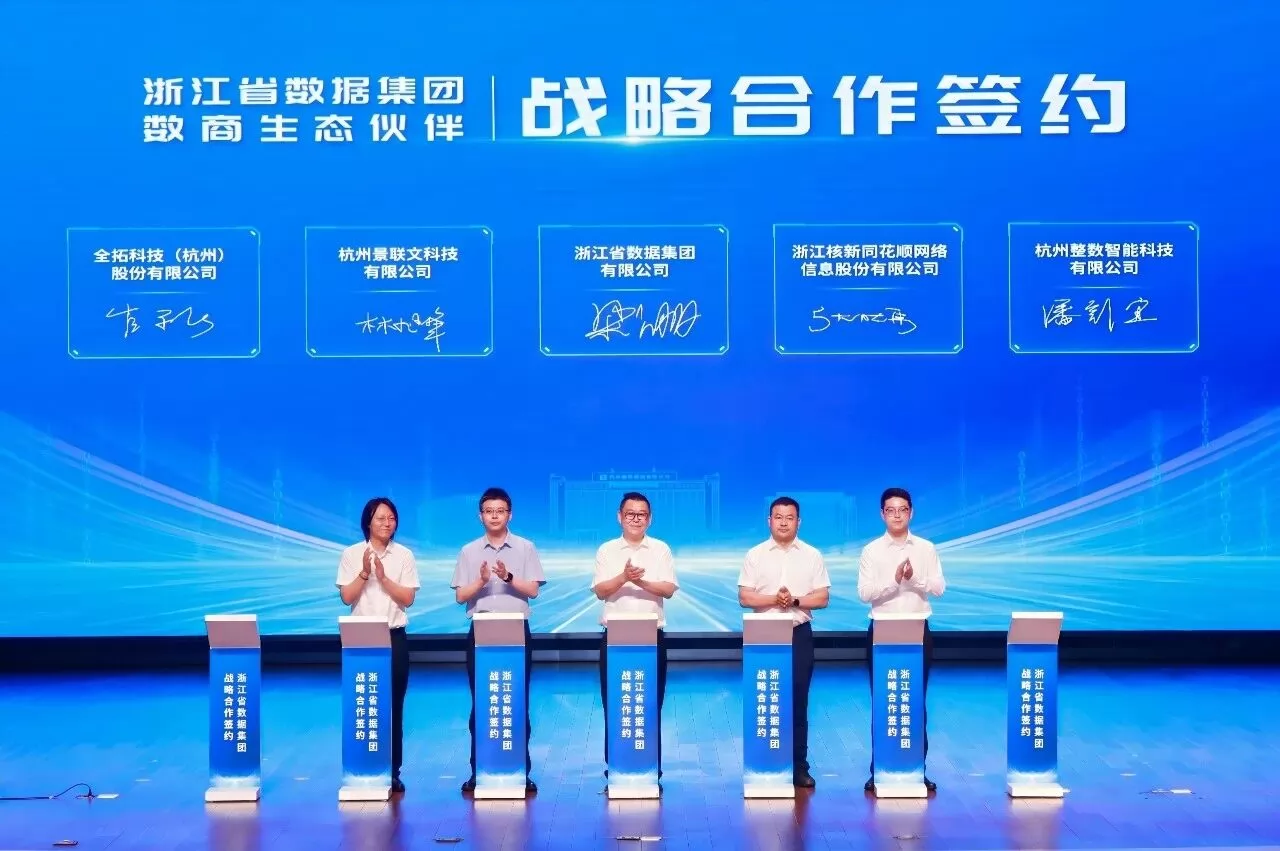
本次数博会相关活动中,景联文还与北京人形机器人创新中心、上海机器人产业研究院、戴盟机器人等10家企业共同发起《机器人产业数据质量与标准创新联合倡议》,推动行业共同建立数据质量与标准体系。
从数据生产,到数据闭环;从单点能力,到产业基础设施。具身智能的数据时代,正在加速到来。


总部地址
杭州市滨江区西兴街道中国数谷3号楼16楼
北京分公司
北京市海淀区光耀东方广场1幢9层902室
重庆基地
重庆市两江新区卉竹路2号互联网产业园2期11号楼5楼
贵阳基地
贵州省贵阳市云岩区中建大厦36楼
微信公众号
客户咨询微信
CopyRight ©️ 2026 杭州景联文科技有限公司 All Right Reserved.