







总部地址
杭州市滨江区西兴街道中国数谷3号楼16楼
毫米之间,重构世界坐标:景联文科技具身数据管线的“精度底座”
语言模型可以消费整个互联网,具身智能却没有这样的捷径。它需要的,是把观测、物理状态与动作耦合在一起的数据——而数据的精度,决定了世界坐标的精度。
具身智能缺的不是数据量,缺的是时序对齐、手在画面、任务完整、带标定、可被模型直接消费的数据;行业不缺采集,缺的是统一标准、可审计质量、可持续扩量的数据管线。DROID等大规模实证研究揭示:数据多样性比数据量更可靠地提升模型性能;当轨迹重复、标注不准、信号同步差时,单纯堆叠数据量收益有限。
景联文科技以“一个定义·两条产线·三级交付·四道检验”为骨架,以44项可测判据为标尺,将「有效小时」作为质量、产能与计价的统一基准,推出具身数据管线。覆盖从纯第一视角、腕部相机、UMI夹爪、动捕手套到真机遥操作的完整采集形态,让数据从“采回来”走向“训得动、验得过、交得清”。
景联文科技对合格具身数据给出明确准入定义:在标准化设备上采集,时序与多视角严格对齐,手在画面内且任务过程完整,带标定与传感器原始信息,经过合规筛除,并可被模型直接消费的连续片段。
核心计量单位是有效小时:通过全部强制项、扣除七类无效项、综合评分不低于70分、合规通过后的数据时长。有效小时同时作为质量口径、计价口径与产能口径,三者取值一致。客户买到的不是“采集时长”,而是真正可训练、可验证、可交付的数据资产。
七类扣除项包括:语义噪声、手部数据缺失、画质不合格、时序异常、设备干扰、合规剔除、任务外时段。每一类都须逐条记录起止时刻与原因,拒绝“只给总数、无法审计”。
原始影像从来不是拿来就能训练的。镜头畸变、位姿漂移、手部抖动、深度空洞——这些藏在原始帧里的误差,如果不经处理,会原封不动地传导给模型,变成机器人动作里的每一次失误。
景联文科技具身数据管线覆盖视频、动作轨迹、姿态,以及按配置接入的触觉/力觉等多模态数据的统一处理及时间戳对齐。在平台技术规划中,预处理进一步分为两层:先通过格式标准化、完整性校验和时空对齐,让原始数据可被一致读取;再通过视觉重建、遥操作解析与跨模态融合,生成具有明确物理含义的训练样本。
多设备格式标准化:面向Ego头显、数据手套、遥操作主手和双臂机器人,统一解析视频、惯性测量单元(IMU)、手指关节角、末端位姿及力觉等数据,转换为一致的内部数据结构。不同设备记录的是不同形态的信号,只有先明确字段、单位与坐标约定,后续算法才能在同一套规则下处理。
完整性校验与异常清洗:检查文件头尾、帧序号连续性和时间戳单调性,识别坏帧、花屏与丢帧,并检查IMU饱和、关节角超限、力传感器断线等异常。低质量片段需要定位到具体时段,采集空档、设备调试和故障段则进入无效数据处理。对于真实操作中的失败轨迹,应与设备故障区分,保留其原因与上下文,为后续纠错学习提供素材。
多模态时空对齐:视频、深度、IMU和机器人关节数据需要在统一时间基准下关联;不同采样率的数据可按训练需求进行插值、滤波与重采样,但长时间缺失不能靠插值“补真”。空间上,还要把手部关键点、物体位置和机器人末端位姿变换到约定坐标系。以抓杯子为例,图像中的接触瞬间、手指闭合和末端受力应对应到同一动作阶段。
几何校正与坐标统一:镜头去畸变依赖相机内参和畸变系数;双目校正则为左右图像建立一致的几何关系,便于由视差恢复深度。手部关键点、物体位置与相机位姿还需要通过外参变换进入约定坐标系,统一长度单位和轴方向。若训练前裁剪或缩放图像,也应同步更新内参和标注坐标,避免画面变了、几何关系却沿用旧值。
Ego视觉重建:从逐帧手部检测出发,结合视觉定位与惯性信息估计相机位置和朝向,再重建每只手的三维关键点。在具备同步多视角视频及相机标定信息时,规划进一步重建全身姿态,并约束手部与身体在腕部的一致性;物体追踪和手物接触识别则作为扩展方向。输出由此从“哪里有一只手”,延伸到“手如何运动、与什么物体发生交互”。
真机遥操作解析:处理双臂关节轨迹、末端位置与朝向,以及三维力和三维力矩,形成标准化运动状态序列。更关键的是对照控制指令与执行反馈,计算期望轨迹和实际轨迹的跟踪误差,定位偏差过大的片段。相比只看动作画面,这类数据还能解释机器人“打算怎么动、实际怎么动、受到了什么力”,为分析执行失败提供依据。
跨模态训练样本生成:对于同次采集、具有可靠时间对应关系的数据,将Ego图像、手部姿态、关节轨迹与末端力觉绑定为“视觉—动作”样本,再按完整任务组织成Episode(一次任务执行片段)。规划还包括关联动作基元标签、生成成功与失败对比样本,使模型既能学习动作示范,也能利用失败回退信息。独立采集的人类示范不能仅凭任务名称相同就与真机轨迹逐帧配对。
在整体技术路线中,这些处理环节与十阶后处理流程衔接:
probe → undistort → slam → handpose → lift → depth → segment → actions → caption → package
在流程上,probe负责前置数据探查,其余环节衔接几何重建、动作理解与交付:
去畸变:结合相机内参与畸变系数完成镜头校正,为后续重建提供一致的成像几何;
位姿解算:采用ORB-SLAM3双目+IMU紧耦合方案解算6DoF相机位姿,赋予物理尺度;
手部姿态:基于HaMeR逐帧预测MANO参数化手部模型,重建手部网格与关键点;遮挡、截断及手套场景的结果需结合质量检查判断有效性;
三维抬升:结合标定与深度信息,将图像关键点映射到三维空间,并对连续轨迹进行时序平滑;
稠密深度:采用FoundationStereo立体深度基础模型,实现逐像素稠密深度;
分割与跟踪:SAM2+BoT-SORT完成物体分割与跟踪;
动作序列:组织与观测对齐的动作标签,并按目标策略的动作空间明确表达方式;
语义描述:Qwen3-VL生成中英文描述,仅在L3语义交付时开启;
封装校验:交付包封装与校验,确保六项交付件齐全。
全部处理保留原始数据与处理记录,每一帧都可回溯到对应的任务、批次与设备。预处理流水线以跟上采集速度、减少数据积压为建设目标,实际吞吐需结合输入规格、硬件配置与并发负载验证。
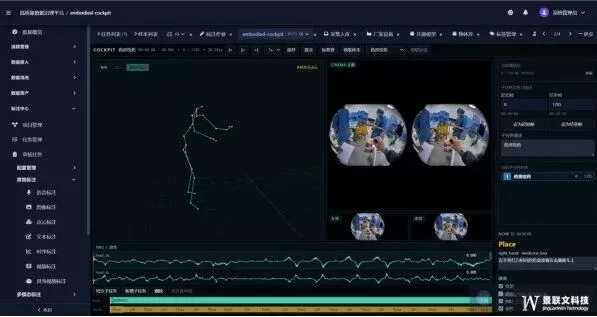
预处理不是“美化”,而是把物理世界的坐标,精确地翻译成模型能读懂的坐标。
单目手部重建的经典难题,是深度方向不受约束、尺度存在歧义。景联文科技的解法,是用一条完整的坐标链把精度钉死:
双目+IMU紧耦合SLAM提供带物理尺度的相机位姿→HaMeR提供MANO手部形状与姿态估计 → 结合标定、三维抬升与稠密深度约束物理尺度 → 在真机场景中通过手眼标定关联相机与机器人坐标系。
精度维度 | 景联文科技标准 | 检测方式 |
相机内参重投影误差 | ≤0.15px | 标定导出 |
手眼标定 · 平移残差 | ≤0.5mm | 标定导出 |
手眼标定 · 旋转残差 | ≤0.1° | 标定导出 |
手部关键点相对误差 | <5 mm | 抽检 |
标注一致性(双人盲标 κ) | ≥0.80 | 双人盲标 |
动作边界误差 | ≤3帧 (100ms@30fps) | 抽检 |
0.15 像素的内参重投影误差意味着标定进入亚像素级;≤0.5mm 的手眼标定残差(适用于腕部相机与真机末端标定),让机器人把「看到的」与「做得到的」对齐到同一条坐标链上;手部关键点相对误差小于 5 mm,才谈得上对灵巧操作的精确示范。
标注环节以一致性κ≥0.80为硬线,低于阈值触发复核并重训标注员。景联文科技要的,不是「看起来对」的数据,而是「经得起双人盲标」的数据。
手-物交互的精细度,取决于深度信息的完整度。景联文科技在数据管线中输出稠密深度图,并对最考验工艺的手部区域单独设防:
手部深度缺失率均值不超过 1%,最大不超过 5%。
深度缺失率反映数据的完整程度,毫米级测量能力还需结合距离误差单独验证。在技术实现上,深度图可通过相机内参反投影为三维点,再通过外参与位姿变换,与手部姿态及动作对齐到约定的世界坐标系(action_frame: world)。只有几何关系、时间关系与有效区域同时明确,手与物体的相对位置才有可比较的基础。
当depth足够密、足够准,机器人才谈得上“灵巧”。
景联文科技具身数据管线不是单一形态采集,而是分层递进的数据金字塔:
L0纯第一视角Ego:头戴式相机,大规模预训练,覆盖场景多样性与任务变体;
L1 Ego+腕部相机:提升手部姿态与接触状态观测精度;
L2 Ego+UMI 夹爪:提供可直接映射至机器人夹爪的动作示范,低成本动作桥接;
L3Ego+数据手套:全手指关节角、手部姿态,精细手部操作;
L4真机遥操作:真实动力学与接触验证,闭环执行锚点。
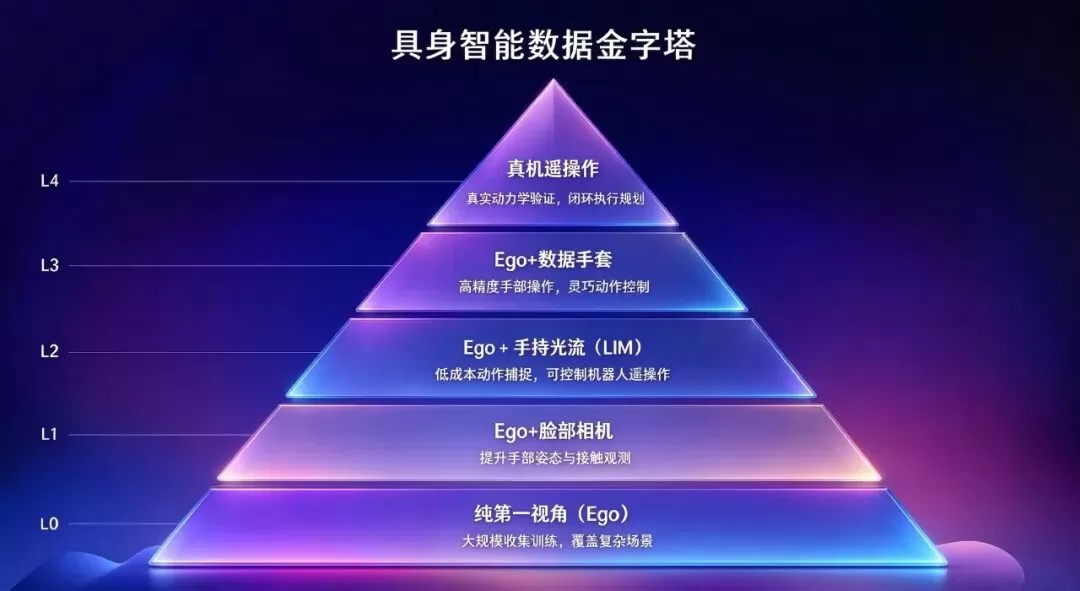
各层通过同任务对齐组关联:同一任务ID、物体版本、初始状态、成功与失败条件。真机失败可回溯至Ego、UMI、手套数据定位原因,形成“看到→理解→迁移→执行”的完整证据链。
生产按两条独立产线组织,互不顶替、不得相互折算:
第一视角线:以头部相机加动捕手套/UMI 为默认形态,按 L2 结构化层级生产,承担预训练与泛化主力;
真机遥操作线:按 L3 语义层级生产,关节指令与失败标注为必备内容,提供真实动力学与接触验证。
一期规划目标为1万有效小时:100套Ego头戴设备、30双手套、3台真机,采集比例约70%纯Ego、27% Ego+手套、3%真机遥操作。
二期方向扩展至10万有效小时:Ego设备≥200套、手套≥100双、UMI夹爪≥50套、真机(双臂/轮式/人形)≥20台,完整覆盖金字塔各层级。
真机线失败与非最优轨迹占比不低于本线总量7.5%,为世界模型与纠错策略提供高价值素材。
三级交付按字段完整度分级:
L1原始:视频流、惯性数据、标定内外参、元数据、质检报告;
L2结构化:在L1基础上增加手部与人体关键点、关节角、参数化模型、深度、物体位姿与轨迹;
L3语义:在L2基础上增加动作基元切分、中英文描述、任务与子任务树、失败标注。
缺少标定或传感器原始信息的数据只能按L1交付,不得升级。主交付格式为MCAP,兼容LeRobot、HDF5与JSON,导出后可直接接入主流训练框架,无需二次转换。
每套交付件确保六项资料齐全:数据集、数据清单、样例包、问题记录、质检说明、标定文件;
万小时级大额订单采用三段式交付:先完成不少于10小时的试采验证,再交付 50% 中期产能,最终完成全量交付。
景联文科技平台覆盖采集任务、采集看板、上传与批次管理、质检任务、Episode 管理、清洗预处理、标注任务、具身视频标注、质量复核、数据集构建、版本归档与客户验收。
生产端实行日级闭环:每天3—4个任务包,小样验证通过后放量;三色门禁控制继续、修订或停采;日终模型回放、失败归因,次日任务修订,形成“采集—评测—优化”日级闭环。
扩量前设置Q1硬门禁,涵盖真机语义有效率、UMI/手套语义有效率、Ego候选可用率、多模态完整率、标注一致性Kappa、近重复率、自动质检时效等指标。任一不达标,不得提前采购二期设备,须整改后复验。
在自动检验与人工抽检之外,景联文科技另设模型验证:每批数据在固定基线模型与固定评测任务集上完成训练验证,记录指标增益、数据效率与负增益复核。自动检验判断“是否合规”,模型验证判断“是否有用”,两者不可相互替代。
合规方面,人脸与身份信息自动模糊召回率不低于98%,门牌、屏幕、证件、车牌同等处理;脱敏保持时序一致性,实行原始区、脱敏区、可发布区三级存储;传输采用HTTPS/SSL,存储采用AES-256,支持私有化部署,数据不出客户网络。开源数据集发布前单独执行完整合规审查。
交付件六项齐全:数据、清单、样例包、问题记录、质检说明、标定文件。万小时级订单执行三段交付:先试采≥10小时验证,再上量至50%,最后全量交付。
具身智能没有捷径。模型能力的上限,取决于数据管线的下限。
从第一视角到真机遥操作,从场景多样性到动作可执行性,从数据采集到模型闭环——景联文科技愿与行业伙伴一起,让机器人真正从“看见”走向“做到”。
如需获取试采包、交付清单样例与具身数据管线合作方案,欢迎后台留言或联系我们咨询对接。


总部地址
杭州市滨江区西兴街道中国数谷3号楼16楼
北京分公司
北京市海淀区光耀东方广场1幢9层902室
重庆基地
重庆市两江新区卉竹路2号互联网产业园2期11号楼5楼
贵阳基地
贵州省贵阳市云岩区中建大厦36楼
微信公众号
客户咨询微信
CopyRight ©️ 2026 杭州景联文科技有限公司 All Right Reserved.